Kubernetes(k8s)
Kubernetes 是个软件系统,它允许你在其上很容易地部署管理容器化的应用,它依赖于 Linux 容器的特性来运行应用, 无须知道这些应用的内部详情也不需要手动将这些应用部署到每台机器。因为这些应用运行在容器里,它们不会影响运行在同一台服务器上的其他应用 ,当你是为完全不同的组织机构运行应用时,这就很关键了 。这对于云供应商来说是至关重要的,因为它们在追求高硬件可用的同时也必须保障所承载应用完全隔离。
核心功能
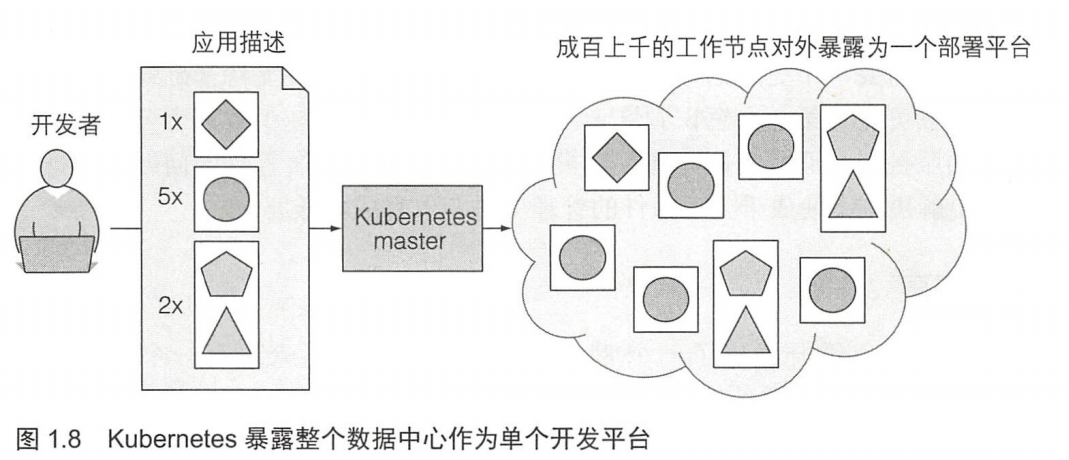
整个系统由一个主节点和若干个工作节点组成开发者把一个应用列表提交到主节点,Kubernetes会将它们部署到集群的工作节点。组件被部署在哪个节点对于开发者和系统管理员来说都不用关心。
集群架构
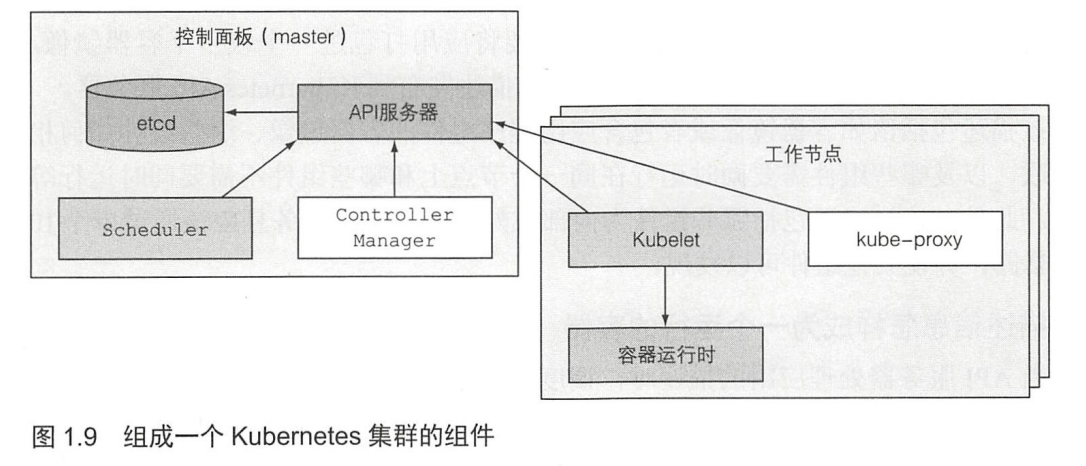
在硬件级别,一个Kubernetes 集群由很多节点组成,这些节点被分成以下两种类型:
- 主节点 ,它承载 Kubernetes 控制和管理整个集群系统的控制面板。
- 工作节点,它们运行用户实际部署的应用。
控制面板
控制面板用于控制集群并使它工作。它包含多个组件,组件可以运行在单个主节点上或者通过副本分别部署在多个主节点以确保高可用性。这些组件是
Kubernetes API 服务器:你和其他控制面板组件都要和它通信。Scheculer:它调度你的应用(为应用的每个可部署组件分配一个工作节点)。Controller Manager:它执行集群级别的功能,如复制组件、持续跟踪工作节点处理节点失败。etcd:一个可靠的分布式数据存储,它能持久化存储集群配置。
控制面板的组件持有并控制集群状态,但是它们不运行你的应用程序。这是由工作节点完成的。工作节点上的组件都需要运行在同一 个节点上, 控制平面的组件可以被简单地分割在多台服务器上。为了保证高可用性, 控制平面的每个组件可以有多个实例。
etcd和API服务器的多个实例可以同时并行工作(etcd 使用 RAFT 一致性算法来保证数据一致性), 但是, 调度器和控制器管理器在给定时间内只能有一个实例起作用 ,其他实例处于待命模式。注:多个调度器:可以在集群中运行多个调度器而非单个。 然后, 对每一个 pod, 可以通过在 pod特性中设置schedulerName 属性指定调度器来调度特定的 pod。未设置该属性的 pod 由 默认调度器default-scheduler 调度。
工作节点
工作节点是运行容器化应用的机器。运行、监控和 理应用服务的任务是由以下组件完成的
Docker、rtk或其他的容器类型。Kubelet: 它与 API 务器通信,并管理它所在节点的容器。Kubernetes Service Proxy(kube-proxy),它负责组件之间的负载均衡网络流量。
rtk:Docker是第一个使容器成为主流的容器平台。 Docker本身并不提供进程隔离,实际上容器隔离是在Linux内核之上使用诸如Linux命名空间和cgroups之类的内核特性完成的, Docker仅简化了这些特性的使用。在Docker成功后, 开放容器计划(OCI)就开始围绕容器格式和运行时创建了开放工业标准。 Docker是计划的一部分, rkt (发音为”rock-it”)则是另外一个Linux容器引擎。和Docker一样, rkt也是一个运行容器的平台, 它强调安全性、 可构建性并遵从开放标准。 它使用OCI容器镜像, 甚至可以运行常规的Docker容器镜像。
运行应用
为了在 Kubernetes 中运行应用,首先需要将应用打包进一个或多个容器镜像,再将那些镜像推送到镜像仓库,然后将应用的描述发布到 Kubenetes API 服务器。
应用的描述包括诸如容器镜像或者包含应用程序组件的容器镜像、这些组件如何相互关联,以及哪些组件需要同时运行在同一个节点上和哪些组件不需要同时运行等信息。此外,该描述还包括哪些组件为内部或外部客户提供服务且应该通过单个 IP地址暴露 ,并使其他组件可以发现
描述信息怎样成为一个运行的容器
当API 服务器处理应用的描述时,调度器调度指定组的容器到可用的工作节点上,调度是基于每组所需的计算资 源,以及调度时每个节点未分配的资源。然后,那些节点上的 Kubelet 指示容器运行时(例如 Docker )拉取所需的镜像并运行容器。
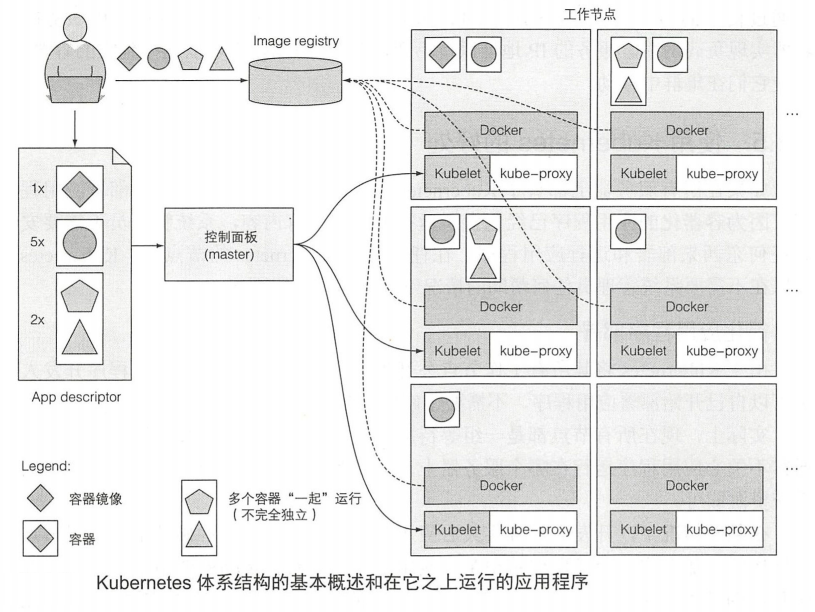
在 Kubernetes 中部署应用程序如下图所示,应用描述符列出了四个容器,并将它们分为 组(这些集合被称为 pod ) 前两个pod只包含一个容器,而最后一个包含两个。这意味着两个容器都需要协作运行 ,不应该相互隔离。在每个pod 旁边,还可以看到一个数字,表示需要并行运行的每个 pod 副本数量。在向 Kubernetes 提交描述符之后,它将把每个 pod 的指定副本数调度到可用的工作节点上。节点上的 Kubelets 将告知Docker从镜像仓库中拉取容器镜像井运行容器。
创建单机k8s
禁用swap分区
Kubernetes 1.8开始要求关闭系统的Swap,可暂时关闭或永久禁用,使用 # free -m 确认swap是否为开启状态
- swapoff -a # 暂时关闭
- vim /etc/fstab # 注释掉swap那一行(SWAP 自动挂载),可永久禁用swap分区
安装kubectl
kubectl用于运行Kubernetes集群命令的管理工具。
1 | # 使用curl下载 |
kubectl常用命令
kubectl run hello-minikube –image=k8s.gcr.io/echoserver:1.4 –port=8080 # 创建pod容器
kubectl create -f 【××.yaml】# 以配置文件形式创建pod容器
kubectl exec 【podname】 – 【命令】#指定pod内部执行指定命令
kubectl get po -A # 查看pod状态
kubectl get nodes # 列出集群节点
kubectl describe node 【nodeName】#查看节点更多详细信息
kubectl cluster-info #展示集群信息
kubectl delete all –all #删除所有资源, all 指定正在删除所有资源类型, –all 选项指定将删除所有资源实例而不是按名称指定它们。使用 all 关键字删除所有内容并不是真的完全删除所有内容。 一些资源(如Secret)会被保留下来, 并且需要被明确指定删除。
安装minikube
注:Minikube 是一个构建单节点集群的工具,对千测试Kubenetes和本地开发应用都非常有用。
1 | curl -Lo minikube https://storage.googleapis.com/minikube/releases/v1.24.0/minikube-linux-amd64 && chmod +x minikube && mv minikube /usr/local/bin/ |
部署
1 | minikube start --vm-driver=docker --registry-mirror=https://registry.docker-cn.com |
清除minikube数据
1 | rm -rf ~/.minikube |
minikube config set memory 4096 # minikube默认情况下仅分配2GB的RAM,需扩内存可使用此命令
minikube dashboard # 访问minikube集群中运行的Kubernetes仪表板
minikube service hello-minikube # 使用minikube可在浏览器中轻松打开此开放节点
minikube start -p cluster2 # 启动第二个本地集群(注意:裸机启动(本次实验环境)不适用)
minikube stop # 停止本地集群
minikube delete # 删除本地集群
删除集群
1 | minikube delete |
停止集群
1 | minikube stop |
使用rc创建应用
1 | # 旧版--generator(已经弃用) 让Kubenetes 创建ReplicationController, 而不是 deployment |
删除应用
1 | kubectl delete rc kubia |
详细信息
1 | [czm@control-plane app]$ kubectl describe pod nginx |
每个 pod 都有自己的 IP 地址,但是这个地址是集群 内部的,不能从集群外部访问 。要让 pod 能够从外部访问 需要通过服务对象公开它, 创建 特殊 LoadBalancer 类型的服务。通过LoadBalancer类型的服务,将创建一个外部的负载均衡,可以通过负载均衡的公共 IP 访问 pod
创建
nginx服务
nginx-rc.yaml
2
3
4
5
6
7
8
9
10
11
12
13
kind: Pod
metadata:
name: nginx
labels:
app: myapp
spec:
containers:
- name: nginx
image: nginx
imagePullPolicy: IfNotPresent
ports:
- containerPort: 80
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
nginx created
[czm@control-plane app]$ kubectl expose pod nginx --port=80 --type=NodePort
[czm@control-plane app]$ kubectl get services
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
kubernetes ClusterIP 10.96.0.1 <none> 443/TCP 9h
nginx NodePort 10.100.4.38 <none> 80:30624/TCP 62m
# 访问服务
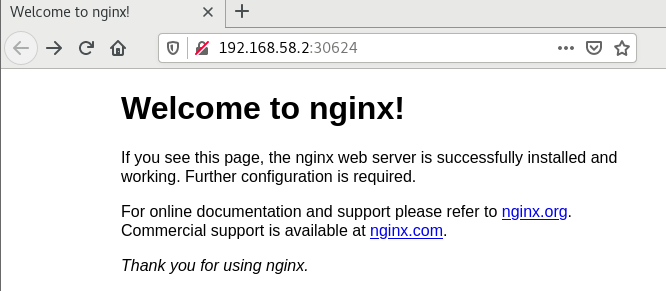
[czm@control-plane ~]$ minikube service nginx
|-----------|-------|-------------|---------------------------|
| NAMESPACE | NAME | TARGET PORT | URL |
|-----------|-------|-------------|---------------------------|
| default | nginx | 80 | http://192.168.58.2:30624 |
|-----------|-------|-------------|---------------------------|
🎉 正通过默认浏览器打开服务 default/nginx...
This tool has been deprecated, use 'gio open' instead.
See 'gio help open' for more info.
打印日志
1 | #pod日志 |
pod
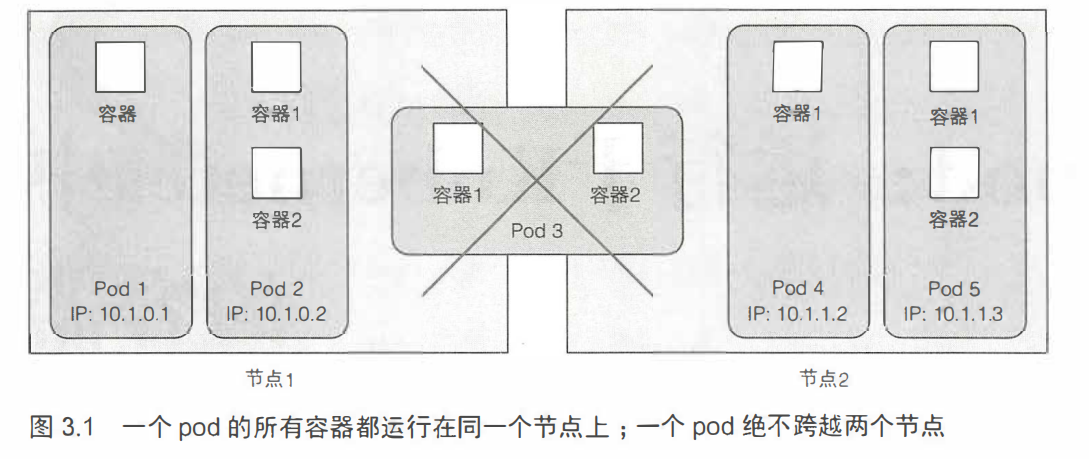
pod是一组并置的容器, 代表了Kubenetes中的基本构建模块(部署单元)。将多个进程聚集在一个单独的容器中,并将它们作为一个单元进行管理,这就是 pod 背后的根本原理。Kubenetes 通过配置 Docker 来让一个 pod 内的所有容器共享相同的 Linux 命名空间,一个 pod 中的所有容器都在相同的 network 和 UTS 命名空间下运行, 共享相同的主机名和网络接口。 同样地, 这些容器也都在相同的 IPC 命名空间下运行, 因此能够通过 IPC 进行通信。 在最新的 Kubernetes 和 Docker 版本中, 它们也能够共享相同的 PID 命名空间(默认是未激活)
pod间网络
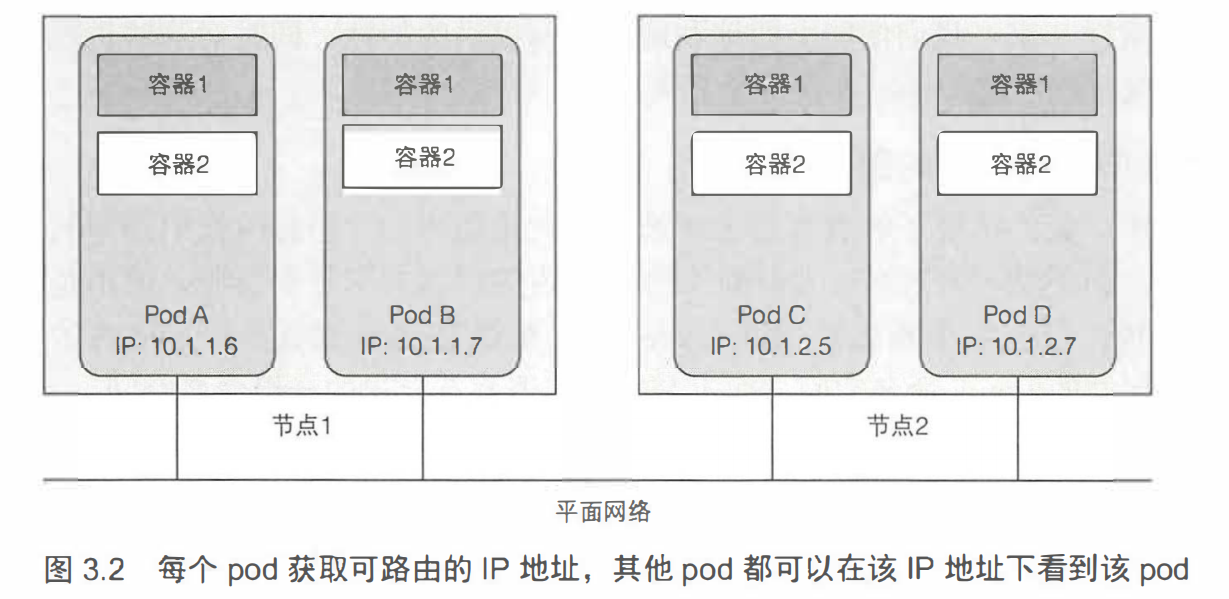
Kubernetes 集群中的所有 pod 都在同一个共享网络地址空间中(如下图所示), 它们之间没有 NAT (网络地址转换) 网关,每个 pod 都可以通过其他 pod 的 IP 地址来实现相互访问。 当两个 pod 彼此之间发送网络数据包时, 它们都会将对方的实际 IP地址看作数据包中的源 IP。
向pod发送请求
通过创建service进行访问。
执行
kubectl port-forward转发本地端口转发到指定pod端口(测试常用)。1
2
3
4
5[czm@control-plane app]$ kubectl port-forward nginx 8000:80
Forwarding from 127.0.0.1:8000 -> 80
Forwarding from [::1]:8000 -> 80
Handling connection for 8000
Handling connection for 8000
Label标签
标记一类pod或拥有特定资源node节点,标签选择器允许我们选择标记有特定标签的pod子集, 并对这些pod执行操作。
1 | # 添加标签 |
将pod调度到特定节点
1 | #为一类节点添加标签,并在pod的yaml文件中添加如下配置 |
注:除标签外,pod和其他对象还可以包含注解。注解也是键值对,但与标签不同,注解并不是为了保存标识信息而存在的,它们不能像标签一样用于对对象进行分组。当我们可以通过标签选择器选择对象时,就不存在注解选择器这样的东西。
命名空间
Kubernetes命名空间简单地为对象名称提供了一个作用域,不同的命名空间可以包含同名的资源。namespace 使我们能够将不属于一组的资源分到不重叠的组中(如按用户进行分组)。
1 | # 列出集群中的所有命名空间 |
指定命名空间
1 | # 1.创建时指定 |
存活探针 (liveness probe)
k8s通过存货探针检查容器是否还在运行。 可以为 pod 中的每个容器单独指定存活探针。 如果探测失败,k8s将定期执行探针并重新启动容器。探测任务由承载pod的节点上的Kubelet 执行。
探测机制
HTTP GET:对容器发起get请求,响应状态码是2xx或3xx, 则认为探测成功。如果服务器返回错误响应状态
码或者根本没有响应,那么探测就被认为是失败的,容器将被重新启动。
TCP:套接字探针尝试与容器指定端口建立TCP连接。如果连接成功建立,则探测成功。否则失败
Exec:探针在容器内执行任意命令,并检查命令的退出状态码。如果状态码是 0, 则探测成功。所有其他状态码都被认为失败。
示例
1 | spec: |
就绪探针
就绪探针的类型与存活探针一样三种。与存活探针不同的是如果容器未通过准备检 ,不会被终止或重新启动。启动容器时,可以为 bernetes 配置 等待时间,经过等待时间后才可以执行第一次准备就绪检查之后,它会周期性地调用探针(默认情况下每10 秒检查一次),并根据就绪探针的结果采取行动。如果某个 pod报告它尚未准备就绪,则会从该服务中删除该pod 。如果再次准备就绪,则重新添加 pod。
示例
1 | spec: |
ReplicationController(rc)
rc是一种Kubenetes资源,可确保它的pod始终保持运行状态。rc会持续监控正在运行的pod列表, 并保证相应的pod的数目与期望相符。
注:上面kubia创建例子就是rc的应用。
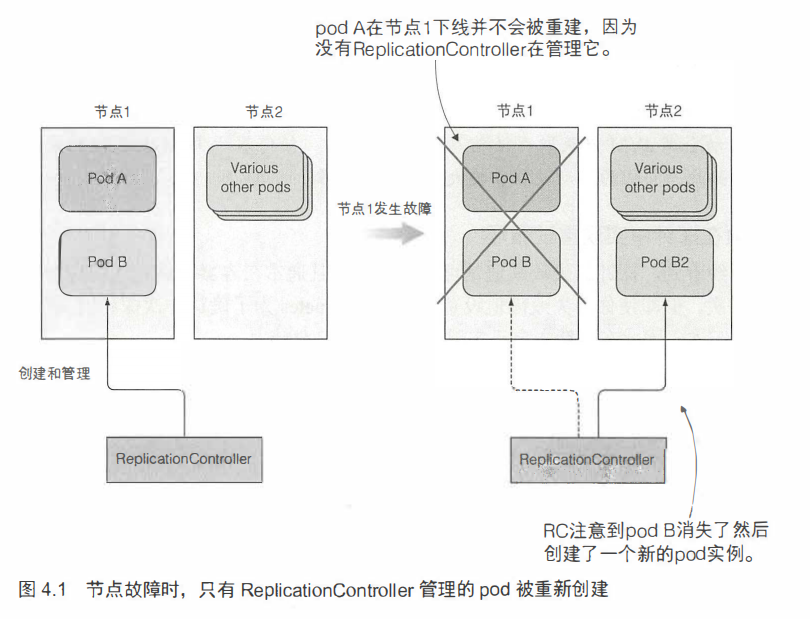
协调流程
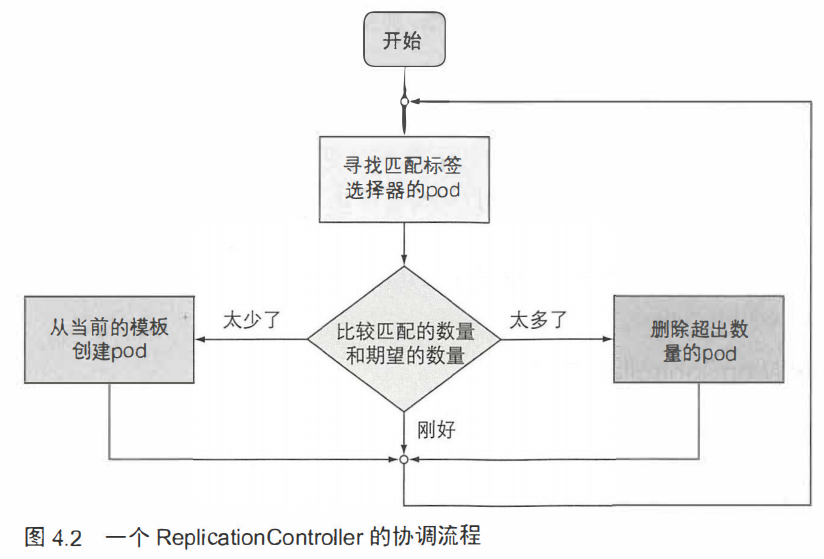
三个主要部分
- label selector ( 标签选择器), 用于确定rc作用域中有哪些pod
- replica count (副本个数), 指定应运行的pod 数量
- pod template (pod模板), 用于创建新的pod 副本
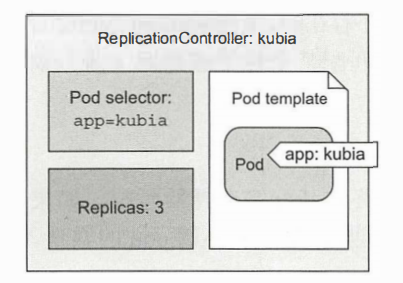
rc与pod关系
rc与pod通过标签关联,对pod删除或添加相关标签可以将pod移出或移入rc的作用域。
修改rc中pod模板
1 | kubectl edit rc 【rcName】 |
扩容
1 | # 直接执行 |
删除rc保持pod运行
1 | kubectl delete rc 【rcName】 --cascade=false |
ReplicaSet(rs)
ReplicaSet (新一代的rc)的行为与ReplicationController 完全相同, 但pod 选择器的表达能力更强。 虽然 ReplicationController 的标签选择器只允许包含某个标签的匹配 pod, 但ReplicaSet 的选择器还允许匹配缺少某个标签的 pod, 或包含特定标签名的 pod, 不管其值如何。
示例
1 | apiVersion: apps/vlbeta2 |
operator (运算符)
- In : Label的值必须与其中 一个指定的values 匹配。
- Notln : Label的值与任何指定的values 不匹配。
- Exists : pod 必须包含一个指定名称的标签(值不重要)。使用此运算符时,不应指定 values字段。
- DoesNotExist : pod不得包含有指定名称的标签,values属性不得指定 。
注:若指定多个表达式,则需要同时成立
DaemonSet(ds)
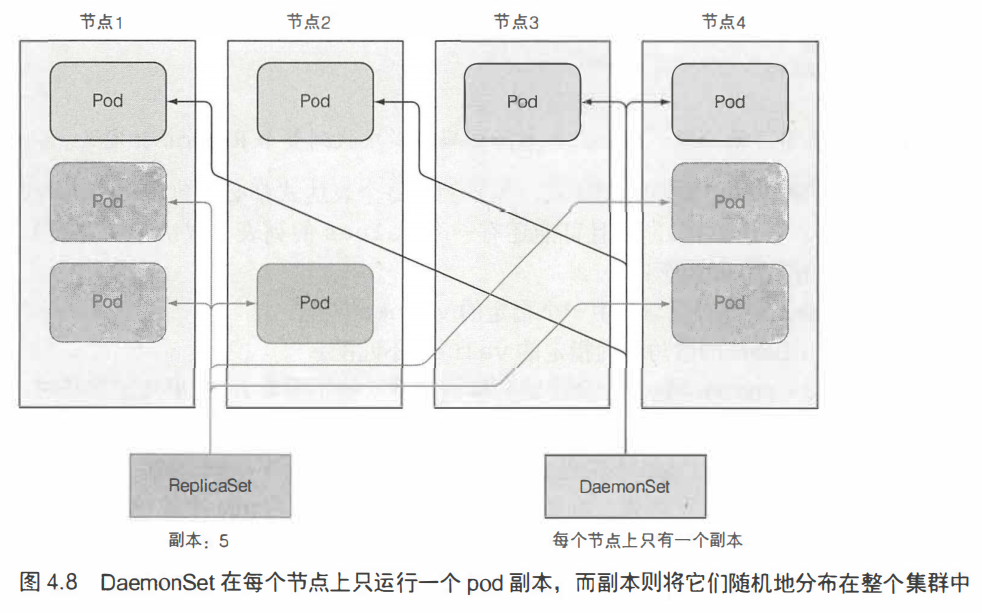
ReplicationController 和 ReplicaSet 将 pod 安排到随机集群节点, 而 DaemonSet确保每个节点都运行一个 DaemonSet 中定义的 pod 实例。DaemonSet 并没有期望的副本数的概念。它的工作是确保一个pod匹配它的选择器并在每个节点上运行 。如果节点下线, DaemonSet不会在其他地方重新创建pod。 但是, 当将 一个新节点添加到集群中时, DaemonSet会立刻部署一个新的pod实例 。
Service服务(SVC)
Kubernetes 服务是一种为一组功能相同的 pod 提供单一不变的接入点的资源。当服务存在时,它的 IP 地址和端口不会改变。 客户端通过 IP 地址和端口号建立连接,这些连接会被路由到提供该服务的任意一个 pod 上。与rc一样通过标签选择器决定哪些pod属于服务。
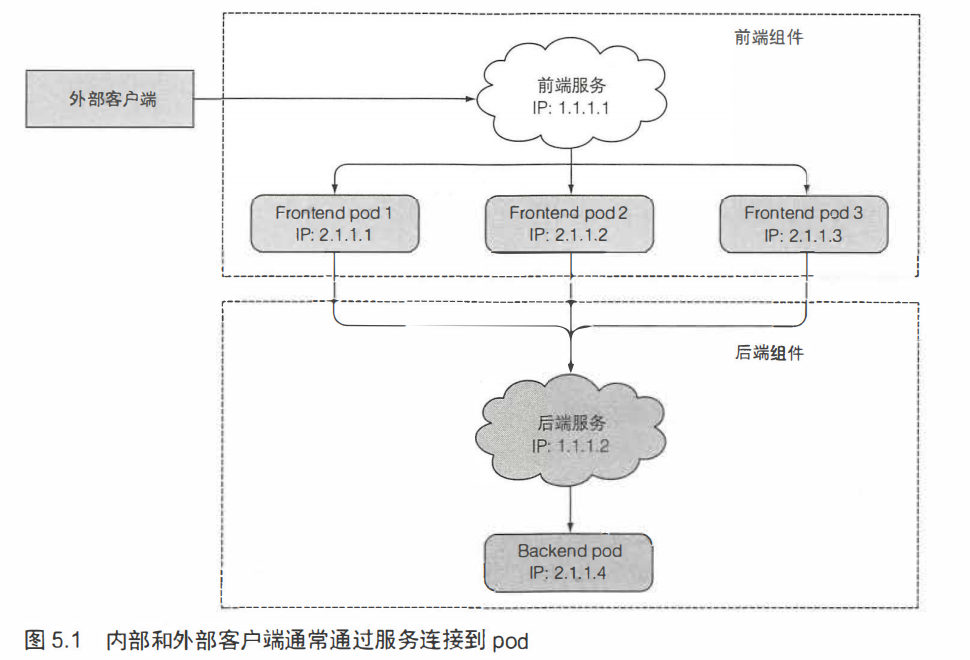
示例
1 | #可直接使用kubectl expose创建,或通过如下yaml配置文件传递到Kubernetes API服务器来手动创建服务 |
通过 FQDN 连接服务
每个服务从内部 DNS 服务器中获得DNS条目(pod 是否使用 部的 DNS 服务器是根据 pod中spec的dnsPolicy 属性来决定的),客户端 pod 在知道服务名称的情况下可以通过全限定域名 (FQDN )来访问
1 | serviceName.default.svc.cluster.local |
访问外部服务
服务不仅可以将连接重定向到集群中的pod,也可以重定向到外部 IP 和端口。在集群中运行的客户端pod可以像连接到内部服务那样连接到外部服务
服务endpoint
服务并不是和 pod 直接相连的。两者之间还有Endpoint 资源,可执行
kubectl describe查看。Endpoint 资源就是暴露一个服务的 IP 地址和端口的列表。尽管服务在 spec 服务中定义了 pod选择器,但在重定向传入连接时不会直接使用它。选择器用于构建 IP 和端口列表,然后存储在 Endpoint 资源中。当客户端连接到服务时,服务代理选择这些 IP 和端口对中的一个,并将传入连接重定向到在该位置监听的服务器。
示例
服务配置
1 | apiVersion: vl |
endpoint配置
1 | apiVersion: vl |
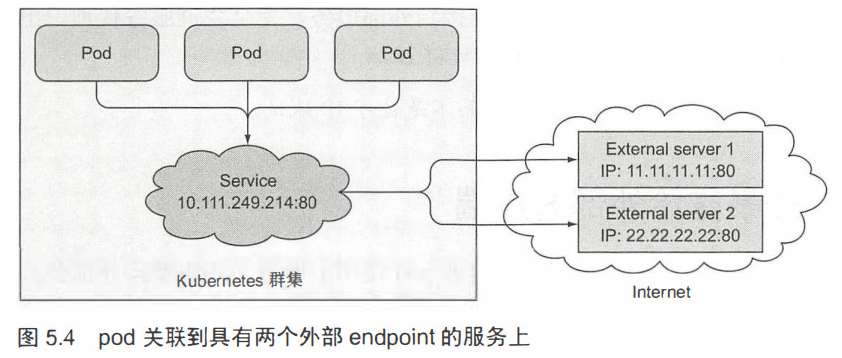
外部服务创建别名
除了手动配置服务的Endpoint来代替公开外部服务方法,有一种更简单的方法,就是通过其完全限定域名(FQDN)访问外部服务。要创建一个具有别名的外部服务的服务时,要将创建服务资源的一个type字段设置为ExternalName。
服务配置
1 | apiVersion: vl |
服务创建完成后,pod可以通过external-service.default.svc.cluster.local域名(甚至是external-service)连接到外部服务。
暴露服务
三种方式
- 将服务的类型设置成NodePort:每个集群节点都会在节点上打开一个端口,对于NodePort服务, 每个集群节点在节点本身(因此得名叫NodePort)上打开一个端口,并将在该端口上接收到的流量重定向到基础服务。该服务仅在内部集群 IP 和端口上才可访间, 但也可通过所有节点上的专用端口访问。
NodePort服务定义
2
3
4
5
6
7
8
9
10
11
12
13
kind: Service
metadata:
name: kubia-nodeport
spec:
type: NodePort
externalTrafficPorcy: Local # 随机选择的pod在接收连接的同一节点上运行.如果没有本地pod存在, 则连接将挂起
ports:
- port: 80 # 服务集群的IP端口号
targetPort: 8080 # 基础服务pod的目标端口
nodePort: 30123 #访问集群的端口,没有指定会随机选择一个端口
selector:
app: kubia
- 将服务的类型设置成LoadBalancer:NodePort类型的一 种扩展,服务可以通过一个专用的负载均衡器来访问, 这是由Kubernetes中正在运行的云基础设施提供的。 负载均衡器将流量重定向到跨所有节点的节点端口。客户端通过负载均衡器的 IP 连接到服务。
- 创建一个Ingress资源控制器, 这是一个完全不同的机制,通过一 个IP地址公开多个服务——它运行在 HTTP 层(网络协议第7 层)上, 因此可以提供比工作在第4层的服务更多的功能。 每个 LoadBalancer 服务都需要自己的负载均衡器, 以及独有的公有 IP 地址, 而 Ingress 只需要一个公网 IP 就能为许多服务提供访问。 当客户端向 Ingress 发送 HTTP 请求时, Ingress 会根据请求的主机名和路径决定请求转发到的服务。
示例
2
3
4
5
6
7
8
9
10
11
12
13
kind: Ingress
metadata:
name : kubia
spec :
rules:
- host: kubia.example.com
http:
paths:
- path: /
backend: # 将所有请求主机kubia.example.com的http请求发送到kubia-nodeport服务的80端口
serviceName: kubia-nodeport
servicePort: 80列出所有Ingress
注:可以调用 kubectl apply - f ××.yaml 修改文件中指定的内容来更新 Ingress 资源,而不是通过删除并从新文件重新创建的方式
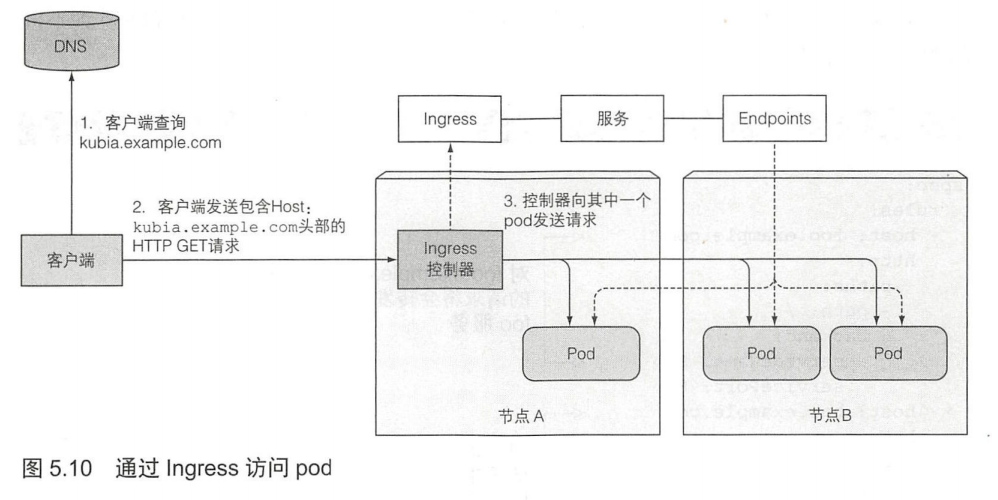
参考
《Kubernetes in Action 中文版》——Marko Luksa